
Программа, которая справляется с работой специалиста, возвращает нас к вопросу «Может ли машина мыслить?», с которого математик Алан Тьюринг начал свою статью 1950 года. В прошлой заметке такой программой была экспертная система R1. По правилам, которые в неё заложили люди, она подбирала всё нужное для заказов на компьютеры фирмы DEC, то есть делала работу опытных сотрудников. Сам Тьюринг предлагал вместо вопроса о мышлении проверять, можно ли по ответам отличить машину от человека. Так устроен тест Тьюринга, о котором я писал в первой заметке. Но понимает ли машина то, что отвечает, и может ли она найти знания сама, без людей, которые пишут правила? На вопрос о понимании ответил философ Джон Сёрл из Калифорнийского университета в Беркли, известный работами о языке. Его статья «Мозг, сознание и программы» (в оригинале Minds, Brains, and Programs) была опубликована в 1980 году в журнале Behavioral and Brain Sciences.
Сёрл рассуждал на примере программ, которые разрабатывала в Йельском университете группа Роджера Шэнка. Эти программы читали короткие рассказы и отвечали на вопросы по ним. Опорой им служили сценарии (scripts), то есть описания привычных ситуаций вроде похода в ресторан, где есть посетитель, официант, меню, счёт и чаевые. Сёрл приводил такой пример. Человек заказал гамбургер, его принесли пережаренным до угольков, и человек в гневе ушёл, не заплатив и не оставив чаевых. Съел ли он гамбургер? Вы, скорее всего, ответите, что нет, хотя в рассказе этого не сказано, и программы Шэнка тоже ответят, что гамбургер он не съел. К 1978 году одна из программ читала английские газетные заметки о дорожных происшествиях и пересказывала их по-английски и по-испански. Пересказы она умела выдавать и по-китайски. Сторонники сильного ИИ (strong AI), по словам Сёрла, считали, что такая программа в буквальном смысле понимает рассказ.
Сильным ИИ Сёрл называл утверждение, что правильно запрограммированный компьютер и есть разум, то есть обладает пониманием и думает на самом деле. Слабым ИИ (weak AI) он называл взгляд на компьютер как на мощный инструмент для изучения разума, и не возражал против такой точки зрения. Сегодня «сильным ИИ» часто называют машину, которая умна, как человек. У Сёрла речь шла не о том, насколько машина умна, а о том, что для разума будто бы достаточно правильной программы.
Против сильного ИИ Сёрл придумал мысленный опыт, в котором человек делает то же, что компьютер с программой Шэнка. Сёрл предложил представить, что в комнате заперли его самого и дали ему пачку листов с китайскими иероглифами. Китайского он не знает, и для него это просто бессмысленные закорючки. Потом ему дают вторую пачку и правила на английском языке, как сопоставлять знаки второй пачки со знаками первой. Знаки он различает только по начертанию. Наконец, ему дают третью пачку знаков, на которую нужно ответить, и дополнительные правила. По дополнительным правилам он в ответ на знаки из третьей пачки выдаёт другие искомые знаки. Люди снаружи называют первую пачку сценарием, вторую рассказом, третью вопросами, а правила программой. Со временем Сёрл так набивает руку, что его ответы не отличить от ответов того, для кого китайский язык родной. «Никто, глядя на мои ответы, не скажет, что я не знаю ни слова по-китайски», — писал он.
Таким образом, несмотря на успешно решённое задание, Сёрл так и не понимает языка, на котором отвечал. Значит, по его словам, и компьютер с программой Шэнка не понимает ни одного рассказа, на каком бы языке рассказ ни был написан. Этот довод, писал Сёрл, годится для любой программы, которая моделирует работу разума, в том числе для SHRDLU и ELIZA, о которых я писал в прошлых заметках. Первая выполняла команды в воображаемом мире блоков и пирамид, вторая была программой-собеседником. С тех пор этот опыт называют «китайской комнатой». Придумал его Сёрл, по собственному рассказу, в самолёте. В конце 1970-х он летел читать лекцию в лабораторию ИИ, где работала группа Шэнка. Об ИИ он тогда ничего не знал и взял в дорогу книгу, которую написали руководители этой группы.
На сам вопрос Тьюринга Сёрл отвечал: «Может ли машина мыслить? Ответ, очевидно, да. Мы сами и есть такие машины». Вопрос, считал он, надо ставить иначе. Достаточно ли машине выполнять подходящую программу, чтобы понимать? По его мнению, нет. У программы есть синтаксис, но нет семантики. Она работает с начертанием знаков, а их смысла не знает. Модель разума, по Сёрлу, не то же самое, что сам разум. Никто ведь не думает, заметил он, что компьютерная модель пожара спалит квартал.
Редакция журнала Behavioral and Brain Sciences перед публикацией статьи Сёрла разослала её другим учёным и опубликовала статью вместе с 27 отзывами. Почти все отзывы оспаривали доводы Сёрла, иногда резко. Информатик Дуглас Хофштадтер из Индианского университета назвал статью одной из самых ошибочных и возмутительных, какие ему приходилось читать. Часть возражений Сёрл разобрал ещё в самой статье. Например, ему говорили, что понимает не человек, а вся система, то есть человек вместе с правилами и листами. Сёрл отвечал, что человек может выучить все правила наизусть и работать без комнаты, и всё равно ничего не поймёт. Отзыв прислал и Шэнк. Он отнёс себя к сторонникам слабого ИИ, хотя и надеялся когда-нибудь перейти к сильному, и признал, что ни одна программа, разработанная его группой, пока по-настоящему не понимает прочитанного. Про китайскую комнату он спросил, кто же тогда понимает, если человек в ней не понимает ничего, и тут же ответил: «Конечно, тот, кто написал правила. А кто он? Тот, кого называют исследователем ИИ».
R1 и программы Шэнка относятся к одному из двух подходов в ИИ, символьному (его также называют символическим), где люди записывают знания правилами. В те же годы снова заговорили о втором подходе, нейросетевом. Нейросеть состоит из простых элементов, похожих на нервные клетки, и у каждой связи между элементами есть вес, указатель важности сигнала. Нейросетевой подход предлагал обойтись без того, кто пишет правила, и дать сети самой подобрать веса на примерах. Самую простую такую сеть называют перцептроном. В 1969 году Марвин Минский и Сеймур Пейперт показали в книге «Персептроны» (так перевели название на русский), какие задачи она не способна решить. После этого к нейросетевому подходу надолго утратили интерес. Обо всём этом я писал во второй заметке. Одним из тех, кто вернул интерес к нейросетям, стал человек со стороны.
Физик-теоретик Джон Хопфилд, профессор Принстонского университета, в 1970-е изучал биологические молекулы и работал также в исследовательском центре Bell Labs. Осенью 1977 года ему позвонил биолог Фрэнсис Шмитт из Массачусетского технологического института, основатель программы исследований мозга. Шмитт собирал в Бостоне семинары, человек по сорок, и пригласил Хопфилда выступить на ближайшем. Потом Хопфилда приняли в постоянные участники семинара. Нейробиологию, по его словам, он узнавал на этих семинарах от лучших специалистов, которые сидели рядом и терпеливо объясняли. Хопфилд считал самым глубоким вопросом о человеке то, как из мозга возникает разум. С 1978 года он моделировал на компьютере, как мозг мог бы вычислять, но около двух лет ничего не выходило. Тогда он взялся за ассоциативную память, которую каждый знает по себе (стоит увидеть человека, и вспоминаешь его имя). И обратил внимание, что память работает по законам, похожим на законы магнитных взаимодействий между атомами и молекулами. Физику магнетизма он знал по работе с физиками-теоретиками Bell Labs.
Обычная память компьютера осуществляет поиск по адресу, то есть по номеру ячейки, и чтобы что-то найти, надо знать, где оно лежит. В статье апреля 1982 года Хопфилд описал память другого рода, которая ищет по содержанию. Его пример — библиографическая ссылка «H. A. Kramers & G. H. Wannier Phys. Rev. 60, 252 (1941)». Такой памяти хватило бы и вот такого обрывка «& Wannier, (1941)», чтобы вспомнить ссылку целиком, а идеальная память нашла бы её и по обрывку фразы с опечаткой. В сети Хопфилда каждый элемент либо включён, либо выключен, и запомненный образ — это состояние всех элементов сразу. Если задать сети начальное состояние, достаточно близкое к запомненному образу, например его часть или вариант с небольшими искажениями, то она сама найдёт искомый образ.
Элементы такой сети влияют друг на друга, и её математическое описание близко к тому, с помощью которого физики описывают магнетизм твёрдых тел. Хопфилд сравнивал поиск в такой сети с шариком, который скатывается в ближайшую ложбину холмистой местности, а ложбины здесь и есть запомненные образы. Статья, по словам Хопфилда, открыла многим физикам и специалистам по информатике дорогу в нейронауку. В 2024 году за работы тех лет он получил Нобелевскую премию по физике.
Новые сети тогда придумывал не один Хопфилд. Кунихико Фукусима из исследовательской лаборатории японской телерадиокомпании NHK ещё в 1980 году описал неокогнитрон, сеть по образцу зрительной коры. Ей не говорили, что нарисовано, но она училась отличать одну фигуру от другой, куда бы фигуру ни сдвинули. От неё потом произошли свёрточные сети (convolutional networks), которые ищут одни и те же признаки по всей картинке, и ими сегодня распознают изображения. Теуво Кохонен из Финляндии в 1982 году описал сеть, которая сама упорядочивает то, что получает. В его опыте на вход подавали сигналы разной частоты. После обучения на каждую частоту откликался свой элемент сети, а соседние элементы откликались на близкие частоты. Похоже устроена и слуховая кора мозга. Обе сети учились без учителя, то есть на примерах без правильных ответов.
Главный вопрос после публикации книги «Персептроны» Минского и Пейперта всё ещё был открыт. Как обучать сеть сложнее перцептрона? В перцептроне на примерах настраиваются только связи, которые ведут прямо к ответу. Такая сеть не решает задачу XOR («исключающее или»), где ответ бывает «да», только когда включён ровно один из двух входов. Сеть с обучаемыми промежуточными элементами решила бы её. Эти элементы снаружи не видны, поэтому их называют скрытыми (hidden), а их ряды скрытыми слоями. Для перцептрона было надёжное правило, по которому веса подправляют на примерах, а для сети со скрытыми слоями похожего правила ещё не знали.
Нужное правило опубликовали в 1986 году в журнале Nature трое учёных, Дэвид Румельхарт, Рональд Уильямс из Калифорнийского университета в Сан-Диего и Джеффри Хинтон из Университета Карнеги-Меллона. С Хинтоном Хопфилд потом и разделил Нобелевскую премию. Сеть даёт ответ, его сравнивают с правильным, и ошибку передают назад, слой за слоем, корректируя на каждом шаге веса всех связей тем сильнее, чем больше связь повлияла на ошибку. Этот способ называют обратным распространением ошибки (backpropagation), и по нему названа сама статья (Learning representations by back-propagating errors). Упрощённо:
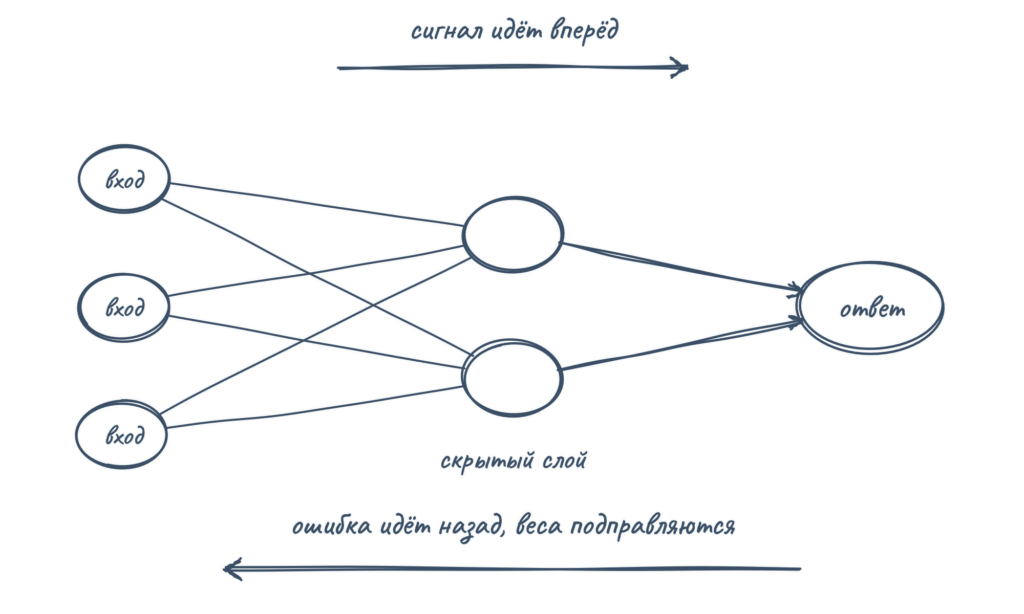
В том же 1986 году Румельхарт, Джеймс Макклелланд и их исследовательская группа в Сан-Диего выпустили двухтомник «Параллельная распределённая обработка» (Parallel Distributed Processing). Название значит, что информацию обрабатывает сразу множество простых элементов. Главу об обратном распространении для него написали Румельхарт, Хинтон и Уильямс. В ней они объяснили, как сеть решает XOR. Сети хватает одного скрытого элемента, который срабатывает, только когда включены оба входа. Входы связаны с ответом и напрямую, и через этот элемент. Напрямую сеть отвечает «да», если включён хотя бы один вход, а сработавший скрытый элемент этот ответ гасит. Так «да» остаётся, только когда включён ровно один вход. Такую сеть обучили обратным распространением, и решение XOR она нашла сама.
Скрытые элементы сами находили в задаче признаки, которых им никто не задавал. Это видно по примеру из самой статьи в Nature. Сеть училась родственным отношениям в двух семьях, английской и итальянской, по двенадцать человек в каждой. На входе она получала, о ком вопрос и какое родство нужно, например «отец», а на выходе должна была назвать родственника. Каждого человека на входе обозначал свой элемент, поэтому по входу нельзя было понять, из какой он семьи. Всего в двух семьях было 104 таких факта. На ста из них сеть обучали, а оставшиеся четыре, которых она не видела, назвала верно. Когда авторы посмотрели, на что откликаются скрытые элементы, оказалось, что один различает семьи, другой поколение, третий ветвь родословного дерева. Ни во входах, ни в ответах таких сведений не было.
Обратное распространение ошибки придумали не они одни. Финский исследователь Сеппо Линнайнмаа описал математику этого способа ещё в 1970 году, вне связи с нейросетями, а американец Пол Вербос применил его к нейросетям в начале 1980-х. Нобелевский комитет в справке к премии 2024 года пишет, что Румельхарт, Хинтон и Уильямс способ переоткрыли. Важнее, по словам комитета, что они показали, как так обученная сеть со скрытым слоем решает задачи, которые без такого слоя не решаются. Кроме того, они объяснили, что делают скрытые элементы. Авторы главы в двухтомнике считали, что ответили Минскому и Пейперту на их вопрос о работе с XOR и что те зря сомневались, можно ли обучать сети со скрытыми слоями. Там же сказано об обратном распространении: «При таком механизме нам, по сути, не нужно знать, как написать программу, чтобы система делала нужное».
Подход, при котором сеть сама подбирает веса, стали называть коннекционизмом (connectionism, от английского connection, «связь»), ведь знания сети хранятся в весах связей между элементами. Как его встретили, описали в статье 1988 года философ Хьюберт Дрейфус, который ещё в 1960-е спорил с исследователями ИИ (о нём я писал в третьей заметке), и его брат Стюарт. В русском переводе статья называется «Создание сознания vs моделирование мозга» (в оригинале Making a Mind Versus Modeling the Brain). По их словам, в первый же день продаж двухтомника «Параллельная распределённая обработка» купили шесть тысяч экземпляров, а исследователи ИИ, уставшие держаться за символьный подход, толпой перешли к новому.
Нагляднее всего возможности обучения на примерах показала сеть NETtalk. В 1986 году Терренс Сейновски из Университета Джонса Хопкинса и Чарльз Розенберг из Принстона научили сеть читать английский текст вслух. Она видела сразу семь букв текста и выдавала звук для средней, четвёртой. Слышно её было через синтезатор речи DECtalk, который выпускала та же компания DEC, для которой делали R1. Училась сеть на записи живой речи первоклассника, переведённой в текст, где у каждого слова было указано и написание, и произношение. Сначала она произносила один гласный звук на все гласные и один согласный на все согласные, и получался лепет. Потом сеть начала различать границы слов, и вышло что-то похожее на слова, а после десяти проходов по тексту её уже можно было понять. Весов у неё было 18 629. Сейновски вспоминал, что все были поражены и что его даже позвали в утреннюю телепередачу Today. Напоминаю, что у GPT-3, вышедшей в 2020 году, весов было 175 миллиардов.
К середине 1980-х на вопрос, откуда в машине берутся знания, было два ответа. В R1 и программах Шэнка их закладывали люди, правило за правилом, и Сёрл считал, что сама такая программа при этом ничего не понимает. Сети вроде NETtalk находили закономерности в примерах сами, но справлялись пока с небольшими задачами. Оба ответа на вопрос, откуда берутся знания, можно было услышать в одном синтезаторе DECtalk. Сам он переводил буквы в звуки по словарю и правилам, которые составили вручную, а сеть, которая говорила его голосом, научилась этому на примерах.
О Lisp-машинах, компьютерах для программ ИИ, о японском проекте компьютеров пятого поколения и об американском ответе на него я писал в прошлой заметке. Как обвалился рынок Lisp-машин, почему разочаровались в экспертных системах, чем кончился японский проект и что стало с американским ответом, я расскажу в следующих заметках.
Литература
Дрейфус Х., Дрейфус С. Создание сознания vs моделирование мозга. В сборнике Аналитическая философия. Становление и развитие под общей редакцией А. Ф. Грязнова. Москва, Дом интеллектуальной книги, Прогресс-Традиция, 1998.
Минский М., Пейперт С. Персептроны. Перевод с английского Г. Л. Гимельфарба и В. М. Шарыпанова. Москва, Мир, 1971.
Сёрл Д. Мозг, сознание и программы. В сборнике Аналитическая философия. Становление и развитие под общей редакцией А. Ф. Грязнова. Москва, Дом интеллектуальной книги, Прогресс-Традиция, 1998.