
Может ли машина мыслить?
Об этом можно было спорить бесконечно, и исследователи довольно быстро перешли к вопросу инженерному.
Какие задачи человека уже можно поручить вычислительной машине?
В прошлой заметке я рассказывал, как из логики, изучения мозга и вычислительных машин сложилась наука, которая в дартмутской заявке 1955 года получила имя Artificial Intelligence, и как в ней наметились две линии: символьный ИИ (его также называют символическим) и искусственные нейронные сети. Авторы заявки исходили из того, что каждый аспект обучения и любое другое свойство интеллекта в принципе можно описать настолько точно, что машину можно заставить его моделировать. Проверять это пришлось на деле, и первые полтора десятилетия показали, что у обеих линий получается, а что нет.
Одной из первых программ, на которых это проверяли, была Logic Theorist Аллена Ньюэлла, Клиффа Шоу и Герберта Саймона, её представили ещё на Дартмутском семинаре. Она доказывала теоремы логики из «Оснований математики» (Principia Mathematica). Перебрать все варианты подряд было невозможно. По оценке авторов, это заняло бы сотни и даже тысячи лет. Поэтому программа отбирала перспективные шаги по правилам-подсказкам, эвристикам (heuristics). Авторы считали эти подсказки похожими на те, которыми пользуется человек, и в 1958 году писали, что на них и держится успех программы.
Для такой работы нужен был свой язык программирования. Языки того времени писали прежде всего для расчётов с числами, а исследователям ИИ нужно было работать с символами, с логическими формулами и связями между понятиями, например такими:
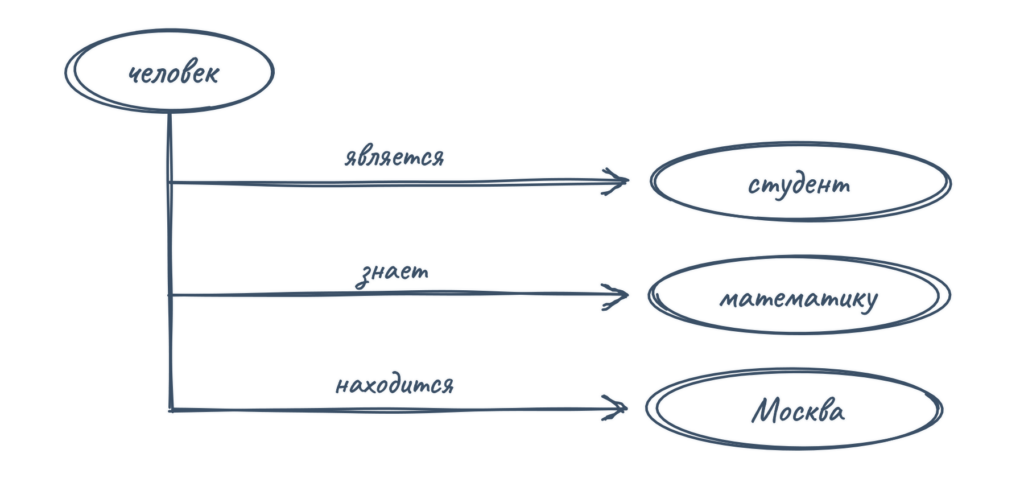
Logic Theorist написали на языке IPL (Information Processing Language, «язык обработки информации»), который Ньюэлл, Шоу и Саймон создали специально для неё. Это язык для работы со списками, то есть с упорядоченными наборами элементов, в которые могут входить и другие списки. Так удобно записывать и формулы, и связи вроде тех, что на картинке. Джон Маккарти познакомился с IPL в Дартмуте и, по его воспоминаниям, тогда же захотел иметь свой язык для работы со списками на вычислительной машине IBM 704. Lisp, как его назвали, начали реализовывать осенью 1958 года в Массачусетском технологическом институте (MIT). В статье 1960 года Маккарти объяснял, что Lisp задуман для опытов с программой Advice Taker. Такой программе можно было бы не только приказывать, что делать, но и сообщать факты, а выводы она делала бы сама, проявляя «здравый смысл». Lisp на десятилетия стал одним из главных языков исследований ИИ.
Потом авторы Logic Theorist попробовали сделать не программу под одну задачу, а общий механизм решения задач, General Problem Solver (GPS, «универсальный решатель задач»). Первый отчёт о нём вышел в конце 1958 года. Программа сравнивает, где она находится и куда нужно прийти, а затем выбирает шаг, который сокращает разницу. Такой приём назвали анализом средств и целей (means-ends analysis). Без эвристик не обошлось и здесь, ведь полный перебор был безнадёжен уже для теорем логики. И это ещё формальная задача, где всё задано заранее, известны и правила, и цель. В реальном мире к этому добавляются неполная информация и неопределённость, и число вариантов растёт так быстро, что с ним не справляются и эвристики. Это выяснилось позже, когда программы стали пробовать на задачах из реального мира.
Символьный подход давал машине правила, по которым она обращается с символами, а нейросетевой предлагал собрать систему из множества простых элементов и дать ей учиться самой. В 1957 году такую систему описал Фрэнк Розенблатт из Корнеллской авиационной лаборатории и назвал её перцептроном. Это было уже ближе к тому, что сегодня называют машинным обучением (machine learning), когда машина учится на примерах. Упрощённо:
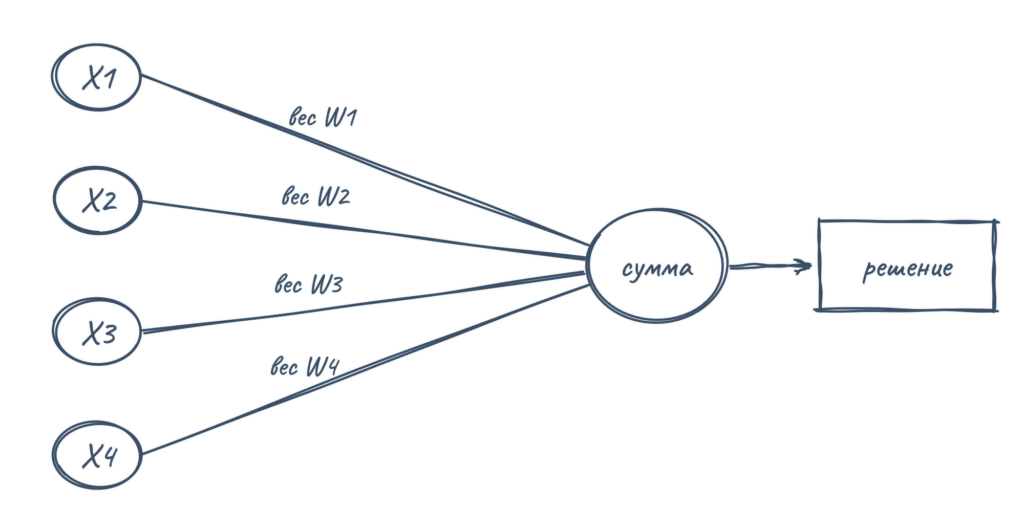
На вход перцептрона приходят сигналы (на схеме X1-X4), и у каждого свой вес. Вес — это указатель важности сигнала для итогового решения. Чем больше вес, тем сильнее сигнал влияет на результат, при нулевом весе сигнал не учитывается совсем, а отрицательный вес тормозит срабатывание элемента. Веса при этом не задают вручную, а подстраивают на примерах. На этом принципе строится и нынешнее машинное обучение. Обученную так систему сегодня называют моделью, а её настроенные веса — параметрами модели. Например, у модели GPT-3, вышедшей в 2020 году, их было 175 миллиардов. То есть вместо правил, написанных вручную, машине дают примеры с правильной разметкой, и модель сама находит закономерности и выводит правила. Так обучать можно очень быстро, а качество обучения во многом определяется качеством примеров.
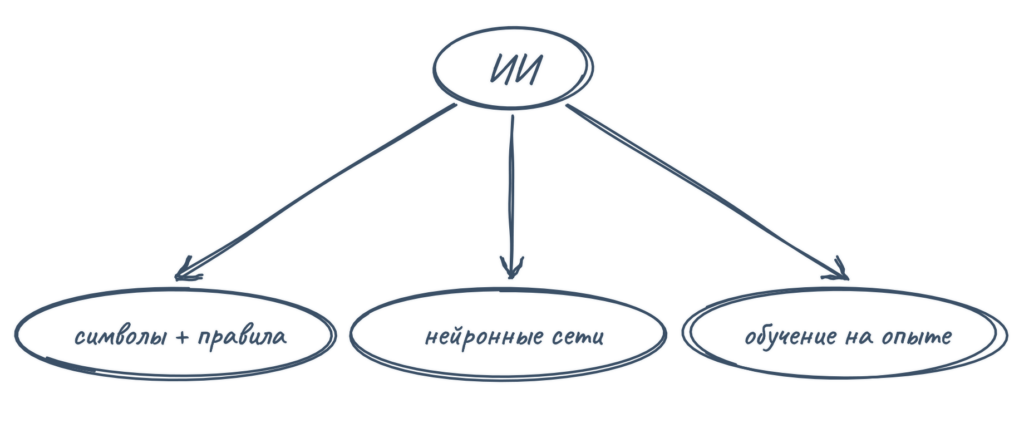
Похожим образом, на собственном опыте, училась шашечная программа Артура Сэмюэла, о которой я уже упоминал. Она запоминала оценённые позиции и, играя сама с собой, подстраивала, насколько важен каждый признак позиции для её оценки, по сути те же веса. В 1959 году Сэмюэл рассказал об этих опытах в журнале IBM Journal of Research and Development, в статье «Некоторые исследования возможности обучения машин на примере игры в шашки» (Some Studies in Machine Learning Using the Game of Checkers). С этой работой связывают раннее употребление термина machine learning в современном смысле. Сэмюэл различал два пути обучения. Первый, «нейросетевой», рассчитывал вырастить обучение в случайно соединённой сети элементов. Второй, который он считал гораздо более эффективным, — заранее устроенная система, которая учится лишь определённым вещам. Его шашечная программа шла вторым путём. Так рядом с двумя линиями появилась третья ветвь:
Кроме обучения, в дартмутской заявке значилось и использование машиной языка, а Алан Тьюринг и вовсе предлагал проверять машину в разговоре. Нынешние языковые модели учатся на огромных массивах текста, а тогда подход был в основном символьный. Компьютеру давали словарь, грамматику и правила, по которым фразу разбирают и преобразуют. Самую известную программу-собеседника тех лет, ELIZA, написал Джозеф Вайценбаум из MIT, и в 1966 году он рассказал о ней в журнальной статье. ELIZA находила во фразе ключевые слова и по заранее заданным правилам разбирала её и собирала ответ. Устроена она была так просто, что подростком я и сам писал похожие программы, простейшие квесты с цепочкой принятия решений или ответы по ключевым словам. Вот фрагмент диалога из статьи Вайценбаума (ответы программы там набраны прописными):
Может быть, я смогу научиться ладить с мамой.
РАССКАЖИТЕ ПОДРОБНЕЕ О ВАШЕЙ СЕМЬЕ
Мама заботится обо мне.
КТО ЕЩЁ В ВАШЕЙ СЕМЬЕ ЗАБОТИТСЯ О ВАС
Мой отец.
ВАШ ОТЕЦ
И всё же собеседники нередко видели в ELIZA больше, чем в ней было. Вайценбаум писал, что некоторых испытуемых было очень трудно убедить, что с ними говорит не человек. Эту склонность приписывать машине понимание и человеческие качества по её поведению позднее назвали эффектом ELIZA (ELIZA effect). Уже в той статье он предупреждал, что ELIZA показывает, «как легко создать и поддерживать иллюзию понимания, а значит, возможно, и суждения, заслуживающего доверия». И добавлял, что «здесь кроется определённая опасность». Через десять лет он развернул эту мысль в книге «Возможности вычислительных машин и человеческий разум» (Computer Power and Human Reason, 1976). Его предупреждение можно свести к одной фразе:
Иллюзию понимания создать легко.
ELIZA отвечала словами на слова, и только. В те же годы в Стэнфордском исследовательском институте (Stanford Research Institute) взялись за задачу другого рода. С 1966 по 1972 год в институте строили робота Shakey, который должен был сам передвигаться по комнатам и взаимодействовать с настоящими предметами. Музей компьютерной истории называет его первым мобильным роботом, который умел рассуждать о своих действиях. У программ вроде Logic Theorist схема была короткой:
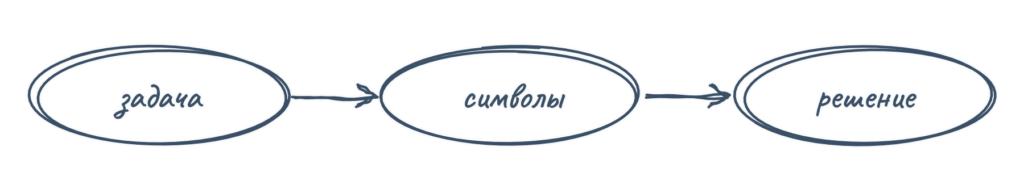
У робота она замыкается в круг:
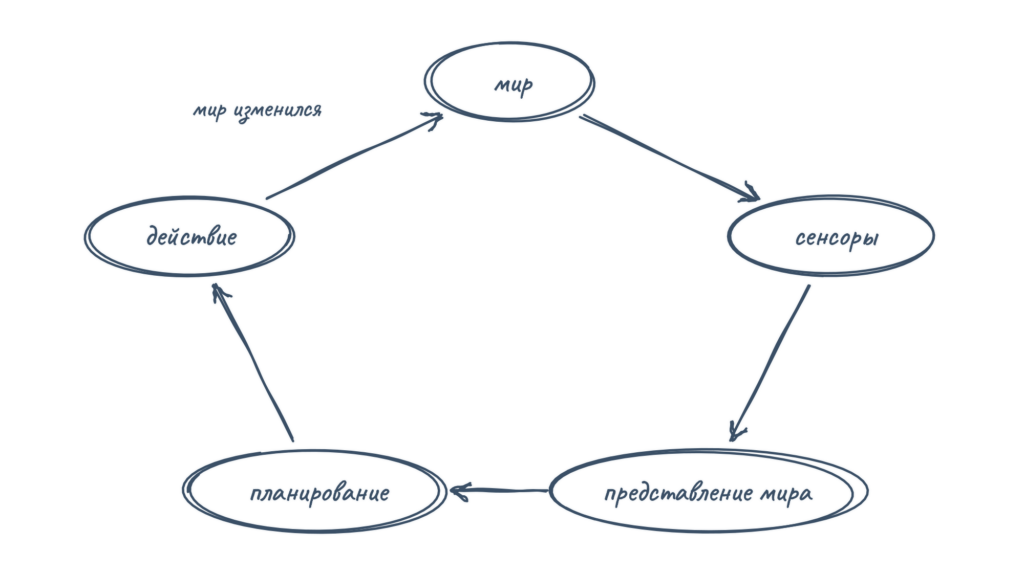
По словам разработчиков, воспринимать и моделировать окружающий мир Shakey умел лишь в ограниченной мере. Но и этого хватало для задач, где нужно спланировать действия, найти путь и переставить простые предметы. Модель мира у Shakey была набором логических утверждений, и по ним он строил планы, то есть это была всё та же символьная линия.
Сторонникам нейросетевого подхода в те же годы приходилось труднее. В 1969 году предел однослойного перцептрона математически разобрали Марвин Минский и Сеймур Пейперт в книге «Персептроны» (Perceptrons). Если настраивается только один слой связей между входами и выходом, сеть решает лишь задачи, в которых ответы «да» и «нет» можно разделить одной прямой линией (при большем числе входов — плоскостью). Самый простой пример, где так не выйдет, — задача XOR, «исключающее или». Ответ должен быть «да», когда включён ровно один из двух входов. Если нарисовать четыре сочетания входов углами квадрата, ответы «да» окажутся на одной диагонали, а «нет» на другой, и одной прямой их не разделить. XOR — частный случай задачи о чётности (ответ зависит от того, чётно ли число включённых входов), которую разбирают авторы.
Многослойные сети тогда тоже изучали, но способа, который обучал бы их так же надёжно, как однослойные, не было. Интерес к нейросетям ослаб ещё в середине 1960-х, а после книги надолго угас и снова вырос только в 1980-е, когда распространился метод обучения многослойных сетей. Часто пишут, что эта книга «убила нейросети», но это упрощение. О возможностях перцептронов спорили и раньше. По оценке социолога науки Микеля Оласарана, книга стала в этом споре последним словом и подтолкнула к его завершению, но были и другие причины: технические трудности, нехватка вычислительной мощности и борьба за финансирование.
К концу 1960-х спор сторонников двух подходов на время закончился в пользу символьного, но до того, что обещали его сторонники, было ещё далеко. Ещё в 1957 году Саймон и Ньюэлл сделали в докладе четыре прогноза, и один из них — что в течение десяти лет вычислительная машина станет чемпионом мира по шахматам. Однако впервые машина обыграла чемпиона мира в матче с обычным турнирным контролем времени только в 1997 году (об этом будет отдельная заметка). Сорок лет спустя Саймон называл те прогнозы весьма удачным упражнением в футурологии и писал, что сделал бы их снова. Я думаю, что, с одной стороны, сложность всегда преуменьшается, а с другой, найти инвестора на технологию, которая заработает через пятьдесят лет, практически нереально, поэтому нужно обещать прорывы буквально завтра. Дело не в честности учёных, а в том, что от них ждут результата прямо сейчас и каждый раз спрашивают, когда же. Примерно так ведёт себя бизнес, когда упал сервис. Сразу требуют срок устранения, хотя с такой поломкой ещё никто не сталкивался и взять этот срок неоткуда. Но срок всегда называют. С учёными так же. Начальство хочет ответ и получает его, а достоверен ли он, не скажет никто.
В 1970-е разрыв между обещаниями и возможностями стал заметен и тем, кто за исследования платил, а платило в основном государство. Финансирование урезали, подходы критиковали, и наступило то, что потом назовут первой зимой искусственного интеллекта. Как это было, от программы SHRDLU до британского отчёта Джеймса Лайтхилла, я расскажу в следующей заметке.
Литература
Вычислительные машины и мышление. Под редакцией Э. Фейгенбаума и Дж. Фельдмана. Москва, Мир, 1967. В сборнике статьи о шашечной программе, Logic Theorist и GPS.
Вейценбаум Дж. Возможности вычислительных машин и человеческий разум. От суждений к вычислениям. Перевод И. Б. Гуревича. Москва, Радио и связь, 1982.
Минский М., Пейперт С. Персептроны. Перевод с английского Г. Л. Гимельфарба и В. М. Шарыпанова. Москва, Мир, 1971.